[00]
我们将整个内容拆分成三个部分: 识别、防护和验证, 先把一个违背常识的事实拿出来摆一摆——百分之八十七的刷流量根本不会触发任何传统的警报阈值标准, 它们的停留时间以及跳出曲线表现得比真实的用户还要稳定, 你现在真正需要做的事情绝对不是去增加防火墙的设备, 而是要重新建立关于流量指纹基线的标准。
[01] 识别
所谓底层逻辑, 其实就是说刷量这个行为, 它的本质含义是制造那些没有任何深度互动行为的会话场景。
因为真实用户在使用的时候, 他们会有滚动动作, 会有点击操作, 并且会存在多条不同的路径分叉;但是刷出来的数据则完全不是这样, 它们表现得像是进入页面后就立刻离开, 整体呈现出一种平平直直、没有任何波动起伏的曲线状态。
设置量化阈值的标准为必须同时满足三个条件才加以标记。
单IP 5分钟窗口内≥200次请求,且页面停留中位数<3秒
同一个User-Agent的使用百分比超过了40%, 并且IP地址的地理位置分布不分散, 其地域集中程度达到了70%以上。
跳出率从行业均值百分之六十二跳到了百分之九十五以上, 这个情况持续了四个小时。
操作步骤:
① 需要去GA4后台把7天内的页面路径数据拉取出来, 然后用浏览量除以独立访客数, 正常情况下这个数值处于1.2到1.8的区间里头, 一旦超过3.0就说明异常了。
服务器中的access.log日志文件需要被处理, 具体方法是使用awk工具来根据IP地址进行统计, 从而计算出每秒查询率也就是QPS这一数据指标的数值, 这里设定的红色警戒线是每秒15次。
命中了IP段, 就去调用IP情报的API接口, 然后把已经知道的CDN内容和数据中心的信息从结果里面排除掉。
当处于验证节点的时候, 在标记之后的四十八个小时以内, 那个异常流量的占比必须要回落到了百分之五这个数值范围以内去, 假如不能做到这一点的话, 就会去触发后面那一轮进行的扫描。
[02] 防护
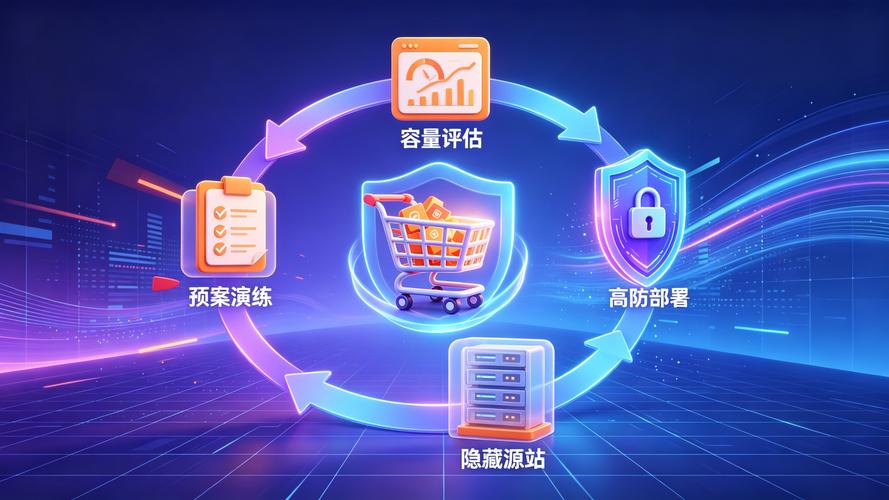
其底层逻辑其实并不是说要采取“阻挡”的办法, 而是应当进行“稀释”与“衰减”。因为如果采用硬拦截的方式, 很容易对真实用户造成误伤。所以正确的模型应该是概率上的衰减, 也就是要把刷量单次请求的边际成本推高, 从而使得攻击者的投资回报率转换为负数。
这是关于双层的参数设置信息。
在边缘这一层里面, 我们把CDN Bot Management这个功能的滑动窗口给开启了, 如果是在10秒钟之内, 访问次数超过了50次的话, 就会触发质询环节, 要把质询的通过率压到2%到3%这个范围里来。
在应用层中, 核心API被设置成了只允许单个IP地址在接下来的60秒这个时间窗口内最多调用30次。如果请求数量超过了这个规定的上限, 系统就会返回状态码为429的信息, 并且后续的重试间隔会按照指数退避的方式来增加计算, 初始的基础时间间隔设置为2秒, 但最大重试等待期限不能超过120秒。
操作步骤:
在 Web 应用防护系统之中新增了会话深度检测的功能, 意思是说单个会话必须经过三个或三个以上的不同网址路径这个条件被满足之后, 才会放行API程序的调用请求。
在针对注册、评论以及搜索这些端点所进行的部署操作当中, 为了进行行为方面的验证, 采用的是把鼠标轨迹的混乱程度也就是熵值和键盘敲击的节奏结合起来作为双重因素的方法, 并且放弃了传统的验证码即CAPTCHA技术。
在第7天的时候, 还要再去做一次全量的日志审计操作。接着, 到了第14天, 也必须再做一次全量的日志审计。在这个过程中,误拦率的红线指标必须是0.3%。
我们来对验证节点的情况进行一次考察, 经过清洗操作之后, 刷量这一行为的单次成本从原来的每一个一千次零点二元人民币, 被抬高到了每一个一千次四点七元人民币, 这样一来, 发动攻击的一方他们的投资回报率就变成了负数, 在这个过程里面的四十八小时之内, 自然衰减的比例会达到百分之八十。
[03] 先进行验证操作, 然后再对问题进行纠正与偏移调整。
要对认知进行纠偏, 就是别拿所谓的流量总量去当作衡量健康的指标。在刷量被清理干净之后, 真实的用户数可能只剩下原来的百分之三十五左右。这并不是一种损失, 而是水分的蒸发过程。
在实证锚点这个方面, 情况是某一个B2B网站完成了为期21天的数据清洗周期, 结果是真实的转化率从原来的0.4%回升到了1.1%, 单个客户的获取成本下降了58%。
今天你打开GA4, 按照[01]三条阈值逐项拉取数据。在10分钟之内, 你需要确认自己没有问题, 或者锁定第一个异常IP段。我们不等下个月了。
相关标签:
相关推荐
老网站进行改版以后, 流量出现下跌的情况, 在百分之九十的时候, 并不是搜索引擎对你实行了惩罚, 真正的原因在于你的团队在部署的这三十分钟的时间内...
把整篇文章拆分成四个模块, 这四个模块分别对应着带宽瓶颈所涉及的四个故障层级, 第一个层级是TCP握手阻塞, 第二个层级是连接池打满, 第三个层级是队列溢出雪崩...
[00]我们将整个内容拆分成三个部分: 识别、防护和验证, 先把一个违背常识的事实拿出来摆一摆——百分之八十七的刷流量根本不会触发任何传统的警报阈值标准...